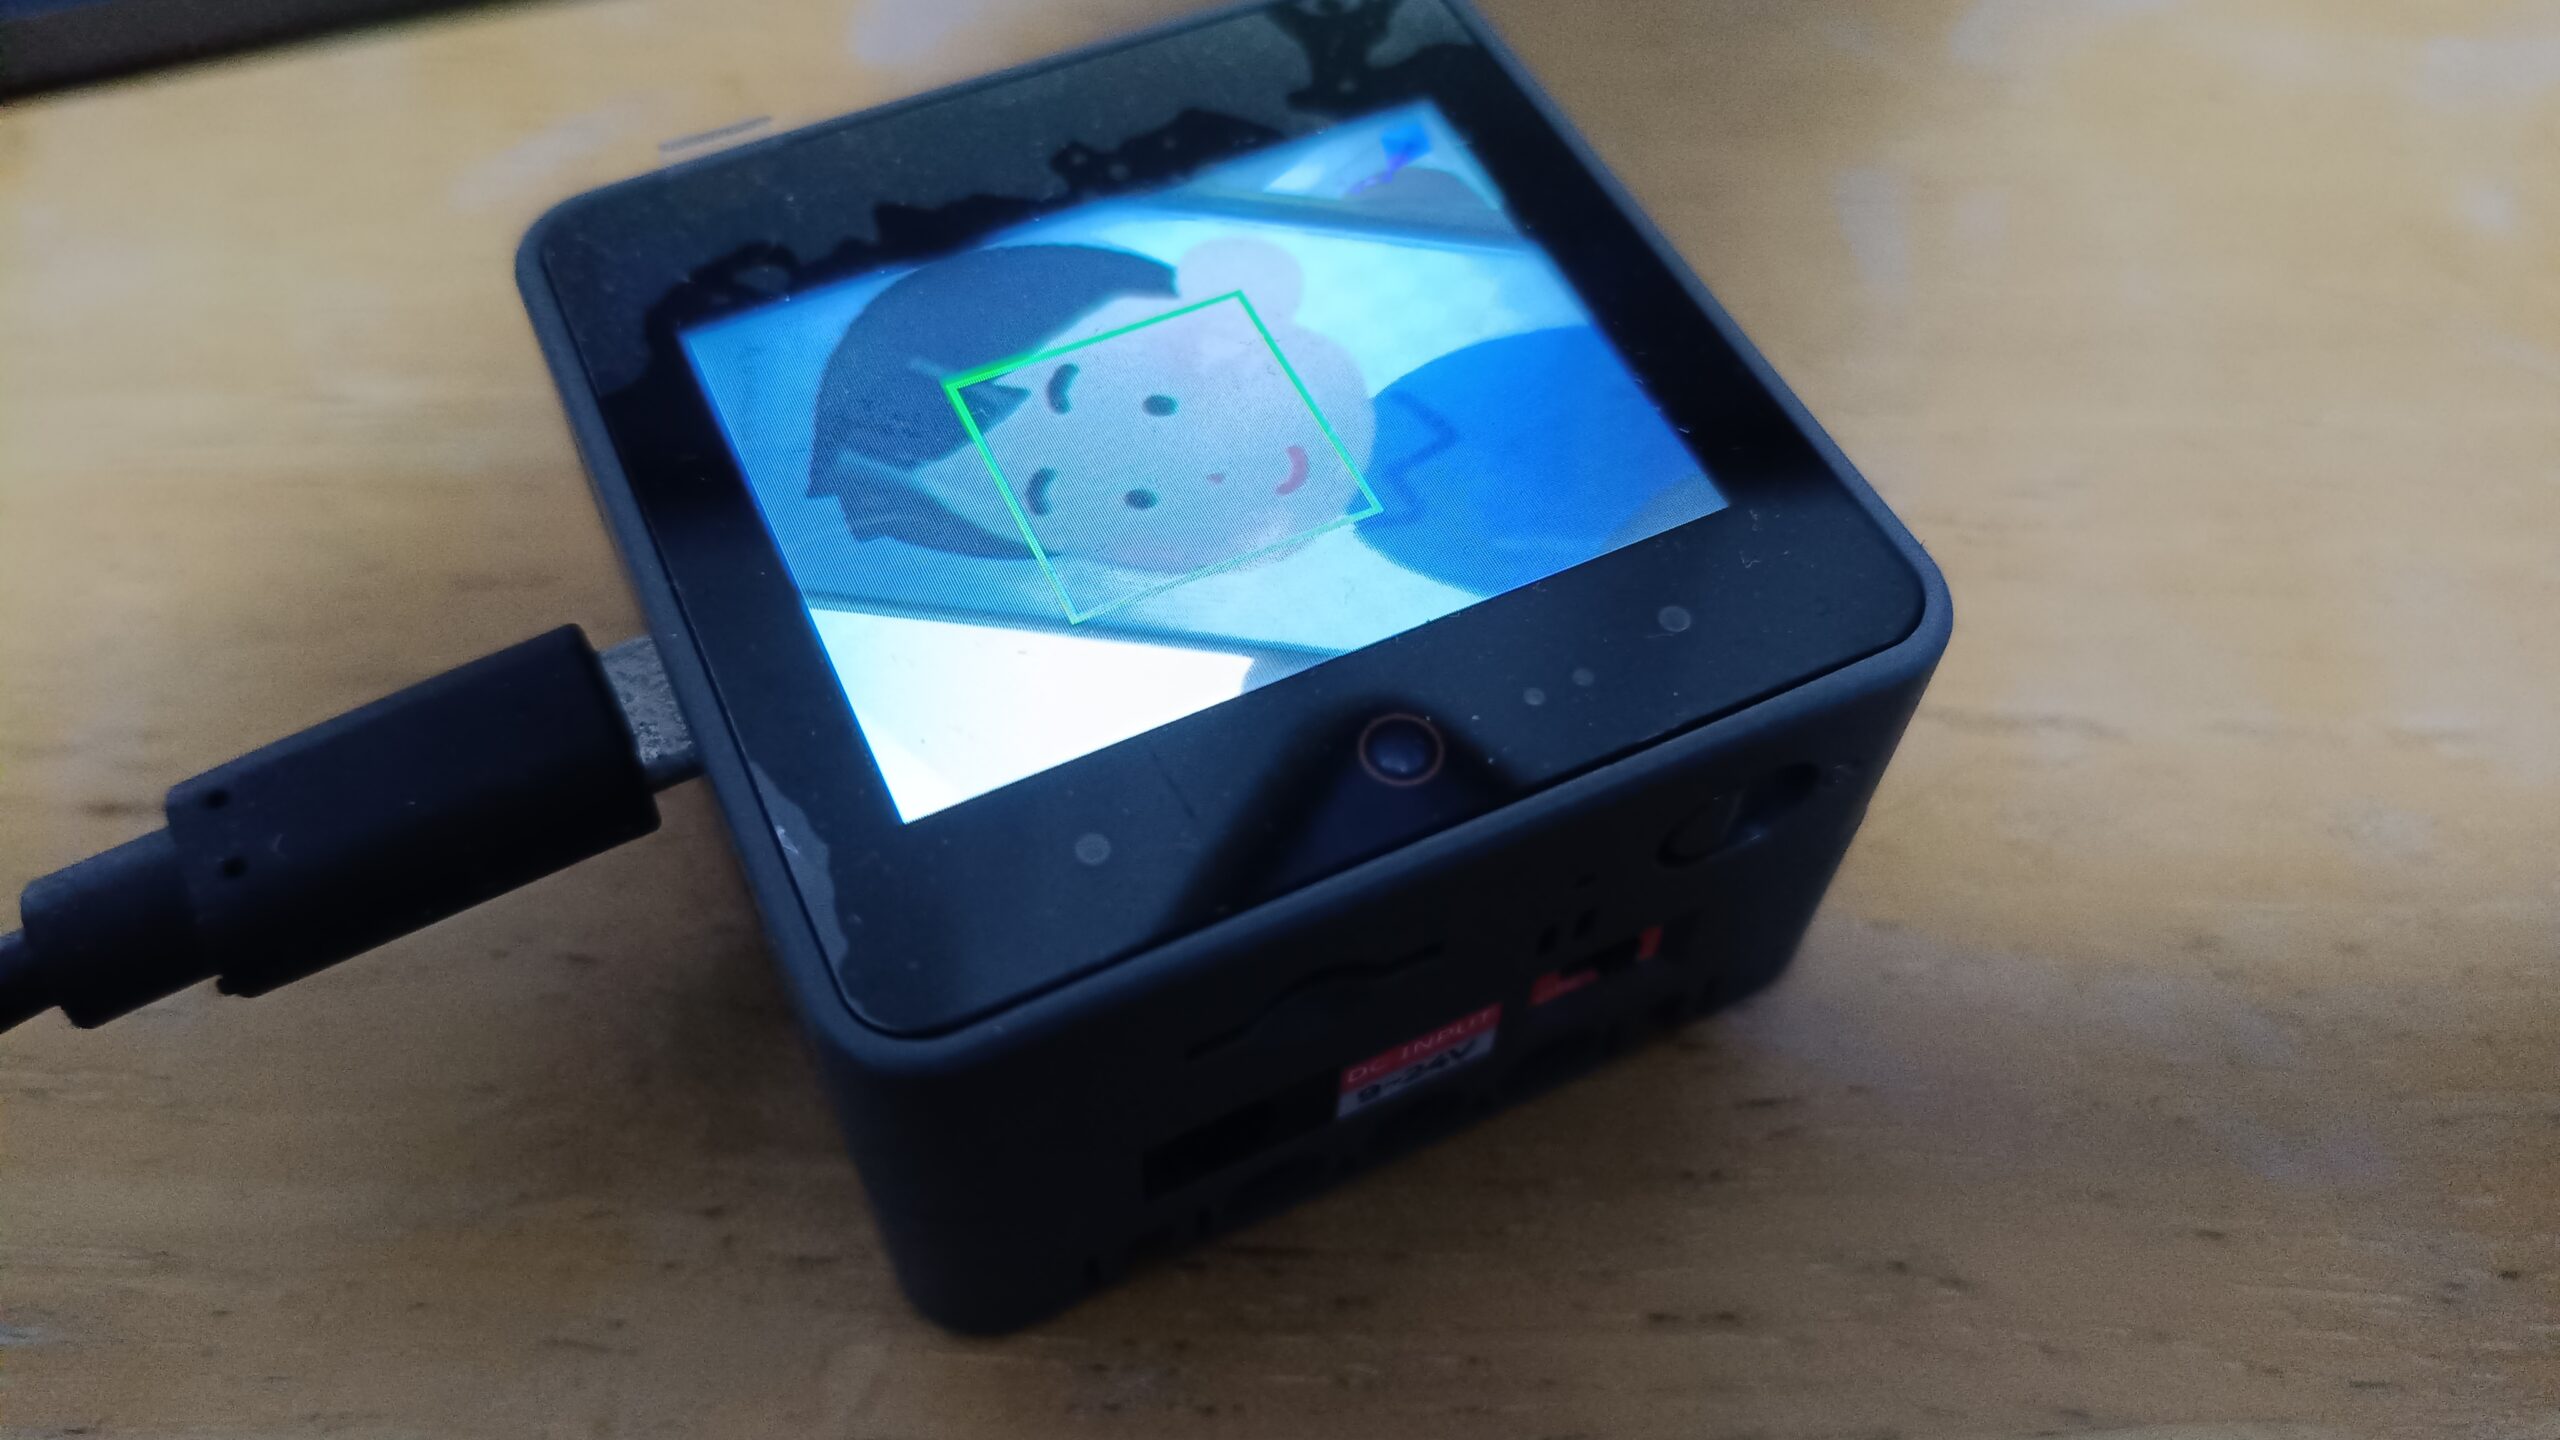
M5Stack CoreS3にZephyr RTOSを導入し、Googleの超軽量顔検出AI「MediaPipe BlazeFace」を動かしてみました。
標準のTensorFlow Lite for Microcontrollers(TFLM)では1回の推論に約22.5秒かかっていましたが、ESP32-S3のSIMD命令を活用した「ESP-NN」を組み込むことで、約1.1秒(20倍高速化)まで短縮できました。
今回は、Zephyr RTOS上でのモデル移植、ESP-NNによる高速化、カメラ描画とAI推論を分離したデュアルスレッド設計について紹介します。
【Zephyr RTOS】M5Stack CoreS3でMediaPipe BlazeFace顔検出!ESP-NNで20倍高速化したメモ
M5Stack CoreS3にZephyr RTOSを導入し、Googleの超軽量顔検出AI「MediaPipe BlazeFace」を動かしてみました。
標準のTensorFlow Lite for Microcontrollers(TFLM)では1回の推論に約22.5秒かかっていました。
そこで、ESP32-S3のSIMD命令を活用した「ESP-NN」を組み込むことで、約1.1秒(20倍高速化)まで短縮できました。
今回は、Zephyr RTOS上でのモデル移植、ESP-NNによる高速化、カメラ描画とAI推論を分離したデュアルスレッド設計について紹介します。
プロジェクト・GitHubのリンク先
GitHubのリンク先は下記です。
実際のデモ動画は下記です。
システム構成と使用モデル
ハードウェアおよびソフトウェアの基本構成は以下の通りです。
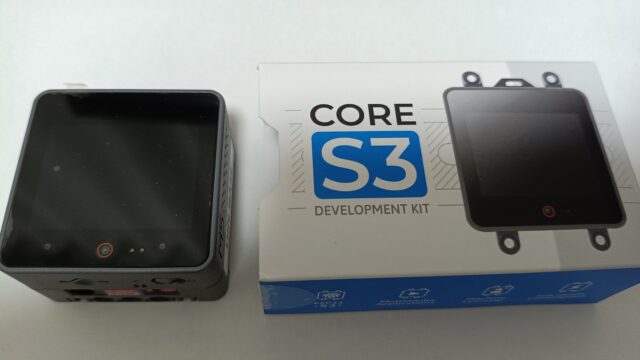
* 開発ボード: M5Stack CoreS3(ESP32-S3FN8, Dual-Core 240MHz, 8MB PSRAM)
* カメラ・LCD: GC0308(DVP接続 VGAカメラ)、ILI9342C(SPI接続 320x240 LCD)
* RTOS: Zephyr RTOS v4.4系
* 推論エンジン: TensorFlow Lite for Microcontrollers(TFLM)
* 高速化ライブラリ: Espressif ESP-NN(Xtensa PIE SIMD命令セット)
* AIモデル: MediaPipe BlazeFace(Short-Range INT8量子化モデル、入力128x128)
推論速度の比較(標準TFLM vs ESP-NN)
標準のTFLMリファレンスカーネル(汎用C++実装)と、ESP-NNによるハードウェア最適化カーネルの推論速度を比較しました。
| 実装方式 | 推論時間 | 高速化倍率 | LCD表示レート | 操作感・体験 |
|---|---|---|---|---|
| TFLM標準 C++ | 22,544 ms (約22.5秒) | 1.0x (基準) | 約6.6 FPS | 顔を向けてから枠が出るまで20秒以上かかり実用困難 |
| ESP-NN SIMD | 1,126 ms (約1.1秒) | 20.0倍 | 約6.6 FPS | 約1秒ごとに顔の位置へ緑枠がスムーズに追従 |
標準のTFLM実装では1フレームの推論に22秒以上を要していましたが、ESP-NNを有効化することで約1.1秒まで高速化できました。
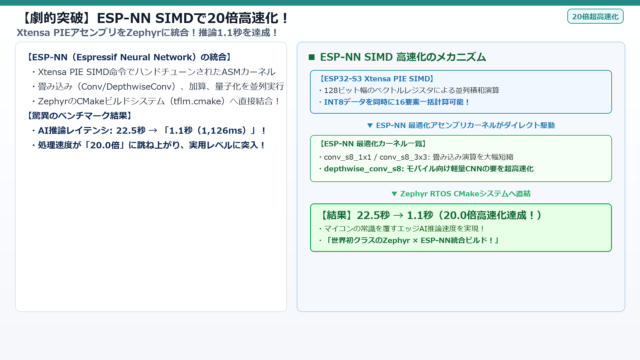
ESP-NNによるSIMD並列最適化
ESP32-S3のXtensa LX7コアには、「PIE(Processor Interface Extension)」と呼ばれるベクトル演算・SIMD命令セットが搭載されています。
ESP-NNは、このSIMD命令を活用して以下の主要レイヤーをアセンブラレベルで最適化するライブラリです。
* 8ビット量子化 畳み込み(Conv2D)
* Depthwise 畳み込み(DepthwiseConv2D)
* 活性化関数(ReLU, Hard-Swish)
* プーリング・加算処理(Pooling, Add)
BlazeFaceの主要な演算処理がベクトルレジスタ上で並列実行されるため、CPUクロックを上げることなく演算時間を大幅に削減できます。
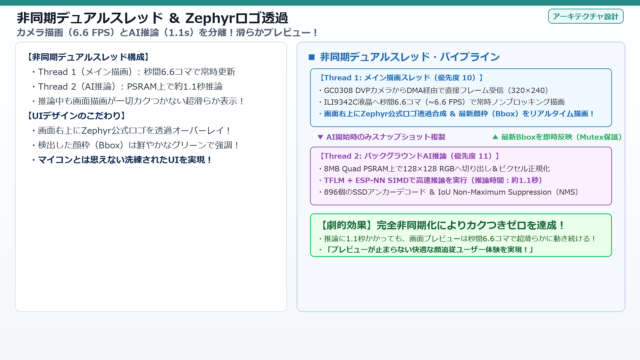
描画と推論を分けたデュアルスレッド設計
マイコン上でカメラプレビューとAI推論を同時に行う場合、シングルスレッドでは推論中に画面描画が止まってしまいます。
そこで、Zephyr RTOSのマルチタスク機能を活用し、役割の異なる2つのスレッドを非同期で走らせるパイプラインを設計しました。
* 描画スレッド(優先度10):
カメラから320x240 RGB565画像をDMAキャプチャし、約6.6 FPSでLCDへリアルタイム転送します。
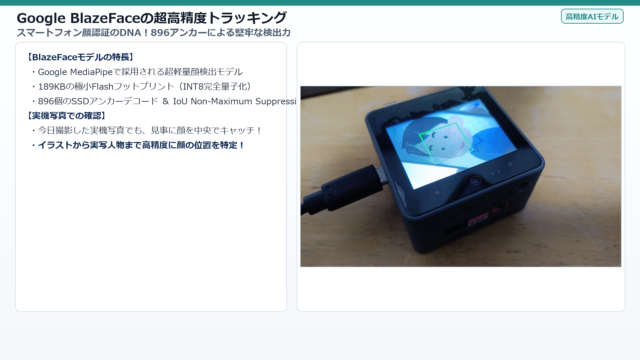
推論結果のバウンディングボックスが存在する場合は、画面上に緑色の矩形(3ピクセル幅)を重ねて描画します。
* 推論スレッド(優先度11):
描画スレッドからカメラ画像を受け取り、中央部分(240x240)を128x128に縮小してTFLMモデルへ渡します。
バックグラウンドで約1.1秒かけて推論を実行し、896個のアンカーボックスのデコードとNMS(Non-Maximum Suppression)フィルタ処理を行います。
確定した顔座標はMutex保護された共有バッファに書き込みます。
推論中もカメラ映像が途切れることなく滑らかに表示され、ストレスのないプレビューを維持できます。
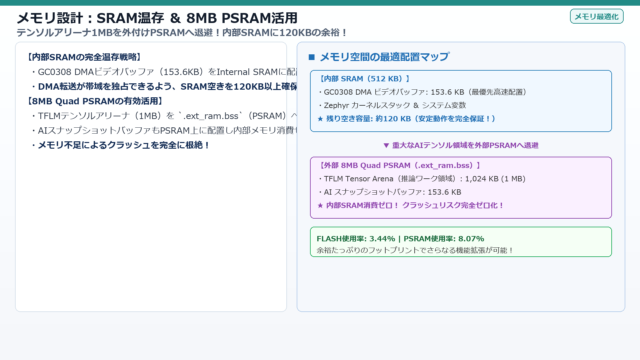
PSRAMと内蔵SRAMのメモリ配置
ESP32-S3の内蔵SRAMは約400KBと限られています。
本システムでは、内蔵SRAMと外部8MB PSRAMの役割を明確に分担させました。
* 内蔵SRAM(DRAM0):
カメラのDMA転送バッファ(153.6KB)とRTOSカーネルスタックのみを配置。
使用量を278KB(約69.8%)に抑え、約120KBの余裕を確保しています。
* 外部PSRAM(Quad PSRAM):
TFLMのテンソルアリーナ(1MB)およびAIスナップショットバッファを配置。
内蔵SRAMを圧迫することなく、大きなモデルと作業領域を安全に確保しています。
実機での動作ログ
ビルドしたファームウェアをM5Stack CoreS3に書き込み、シリアルコンソールで動作を確認しました。
|
1 2 3 4 5 6 7 8 9 |
[MAIN] Initializing BlazeFace Detector... [BLAZEFACE] TFLM Model initialized successfully! [BLAZEFACE] Input tensor: dims=[1,128,128,3] type=1 bytes=196608 [BLAZEFACE] Arena used: 603152 / 1048576 bytes [00:00:03.780,000] <inf> camera_blazeface: [AI_THREAD] Background AI inference thread started [00:00:03.798,000] <inf> video_gc0308: Stream started [APP] Preview: 14 frames (~6.6 FPS) | Faces: 0 | AI Infer: 1126 ms [BLAZEFACE] Detected 1 face candidate(s) [APP] Preview: 14 frames (~6.6 FPS) | Faces: 1 | AI Infer: 1126 ms |
起動後、推論時間1,126msで安定して顔が検出され、LCD上に緑色の枠がリアルタイムに表示されることを確認できました。
まとめ
M5Stack CoreS3とZephyr RTOSを組み合わせ、MediaPipe BlazeFaceによるエッジAI顔検出を構築しました。
* ESP-NNによる20倍高速化: SIMD命令の活用により、推論時間を約22.5秒から約1.1秒へ大幅短縮。
* デュアルスレッドパイプライン: プレビュー描画(約6.6 FPS)を止めずにバックグラウンドで推論を実行。
* 適切なメモリ配置: DMAバッファを内蔵SRAM、テンソルアリーナをPSRAMに分離して安定動作を実現。
Zephyr RTOS上で動かすESP32-S3のエッジAI開発の参考になれば幸いです。
コメント